不做锆石的那一半 U–Pb 定年,
现在可以在浏览器里跑
每一个计数,都算数。Every count counts.
Isoclock 是一个离线的 LA-ICP-MS U–Th–Pb 数据归算程序,专为 含可变普通铅的矿物(磷灰石、榍石、白钨矿、独居石等热液与副矿物)设计。 这个仓库是它的一个维护分支:科学逻辑一行未改,修的是工程问题, 另外补了一个零依赖、可离线、能直接发给同行的单文件网页版。
Isoclock is offline data reduction software for LA-ICP-MS U–Th–Pb dating of minerals carrying variable common Pb — apatite, titanite, wolframite and other hydrothermal or accessory phases. This repository is a maintained fork: the scientific method is untouched, the engineering problems are fixed, and a zero-dependency single-file browser version has been added.
锆石的数据一般贴着曲线走;换成磷灰石、白钨矿这类普通铅含量高的矿物, 数据点会成片落到曲线下方——这正是 Isoclock 存在的理由,也是它和 主流锆石软件(如 Iolite、IsoplotR 的锆石流程)最大的分歧点。
图按 λ₂₃₈=1.55125e-10 / λ₂₃₅=9.8485e-10 / ²³⁸U:²³⁵U=137.818 现算, 见 图解第 1 章。 网页版现在也能直接出这张图了(连谐和年龄与 discordia 交点一起), 见下面「新增的 IsoplotR 谐和图」一节。
它在做什么What the software does
激光剥蚀进样 → 质谱测计数率 → 一条完整的归算链 → 每个点的年龄 + 不确定度。 中间那一步"归算"就是 Isoclock 干的活。
- 导入原始信号
直接读仪器导出的原始文件:Thermo(
.csv)、Agilent(.csv+ 可选样品名清单)、 Element(.fin专有二进制,需要先用桌面版转换)。 一次可以丢进一整批,程序按文件名/清单分配样品名。 - 背景校正与离群剔除 自动或手工识别每段信号的背景窗与积分窗,扣背景、算净计数率, 按 2σ 剔除离群测量。
- 标样普通铅校正 用已知年龄的标样反推普通铅的同位素组成,四条路径可选 (²⁰⁴Pb / ²⁰⁷Pb / ²⁰⁸Pb / Cal 204Pb)——这一步是这个软件的看家本领, 见 图解第 3 章。
- 下向分馏标定
激光剥蚀时不同质量数的离子行为不同,比值会随剥蚀深度漂移;
用标样拟合出漂移规律再套到样品上(
Age76Pb)。 - Sample–Standard Bracketing 年龄 用前后夹着的标样做外标,把样品比值换成年龄,输出四个体系 (²⁰⁶Pb/²³⁸U、²⁰⁷Pb/²³⁵U、²⁰⁸Pb/²³²Th、²⁰⁷Pb/²⁰⁶Pb)的年龄表。
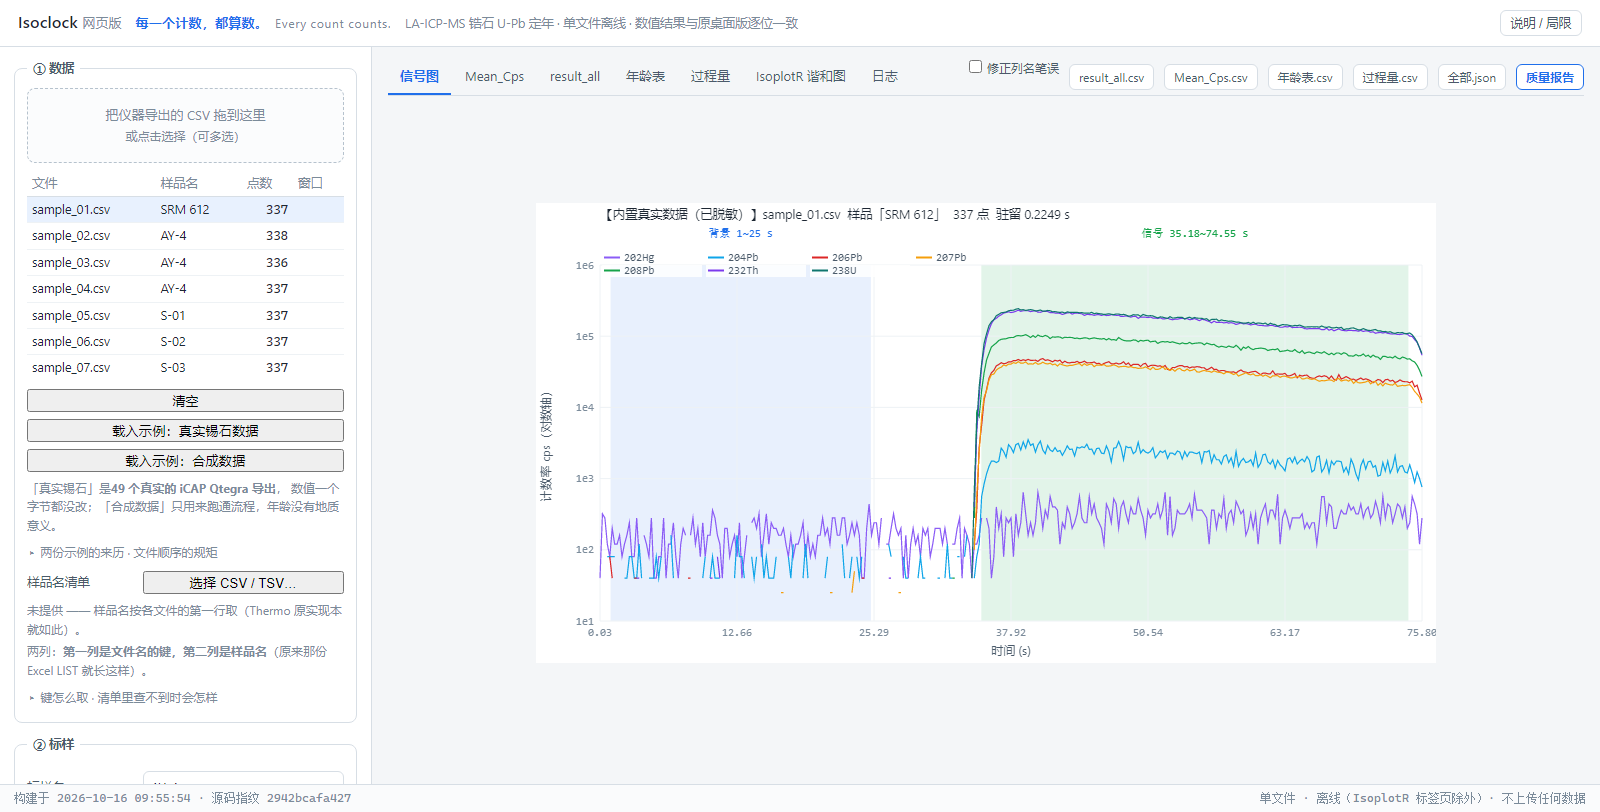
输出什么
Mean_Cps.csv
每个积分窗口的平均计数率与标准误。想自己复算或画图,从这里接。
mean count rates + 1σ
result_all.csv
逐点的比值、相关系数 rho、误差传递后的完整结果。
per-spot ratios & errors
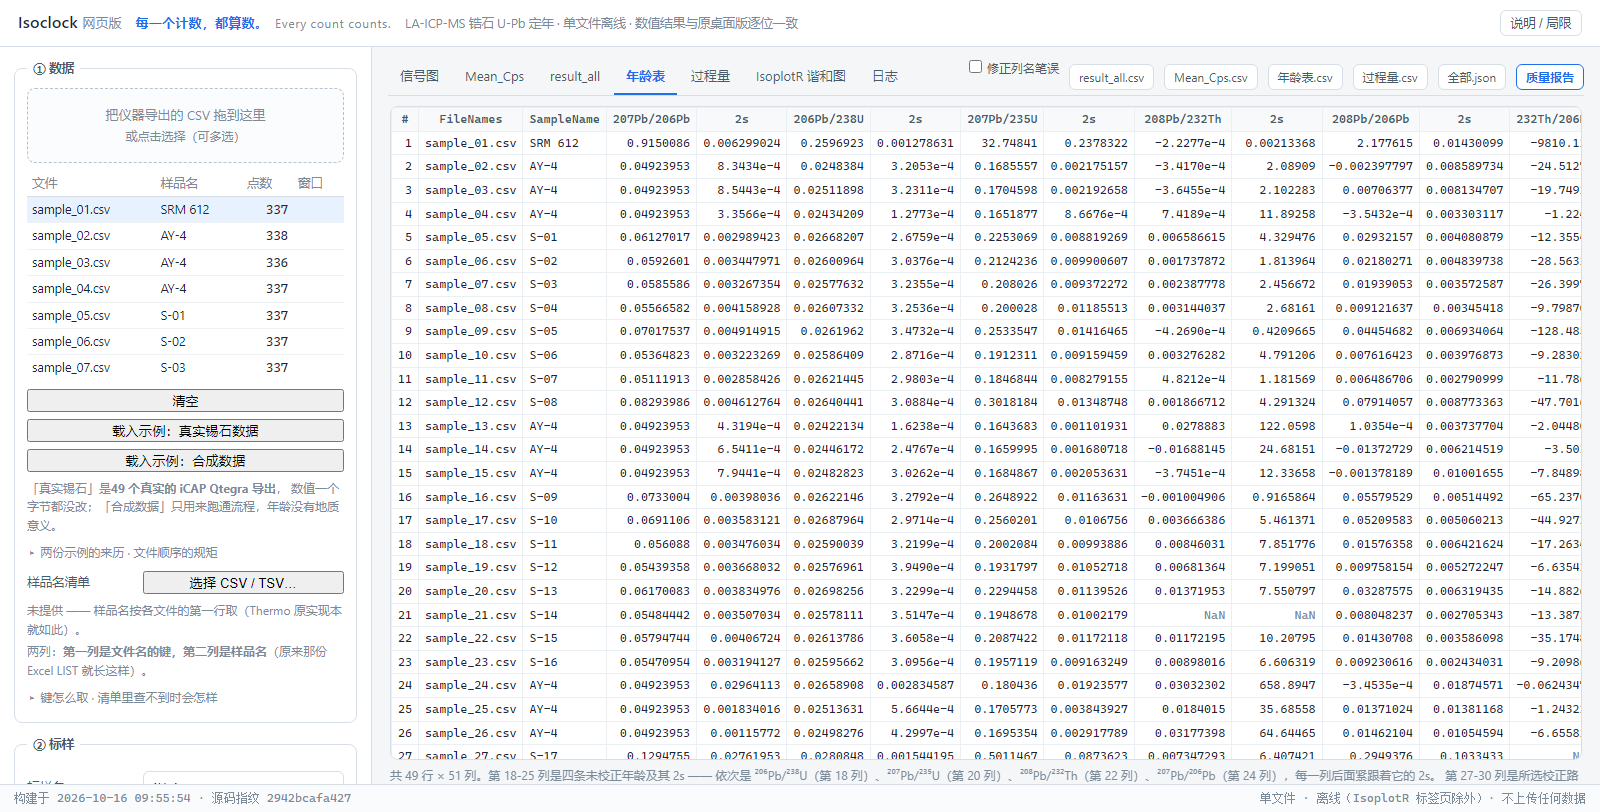
年龄表(51 列)
四个体系的年龄与 2σ,分校正前/校正后。可在界面里直接看、导出 CSV。
ages, uncorrected & corrected
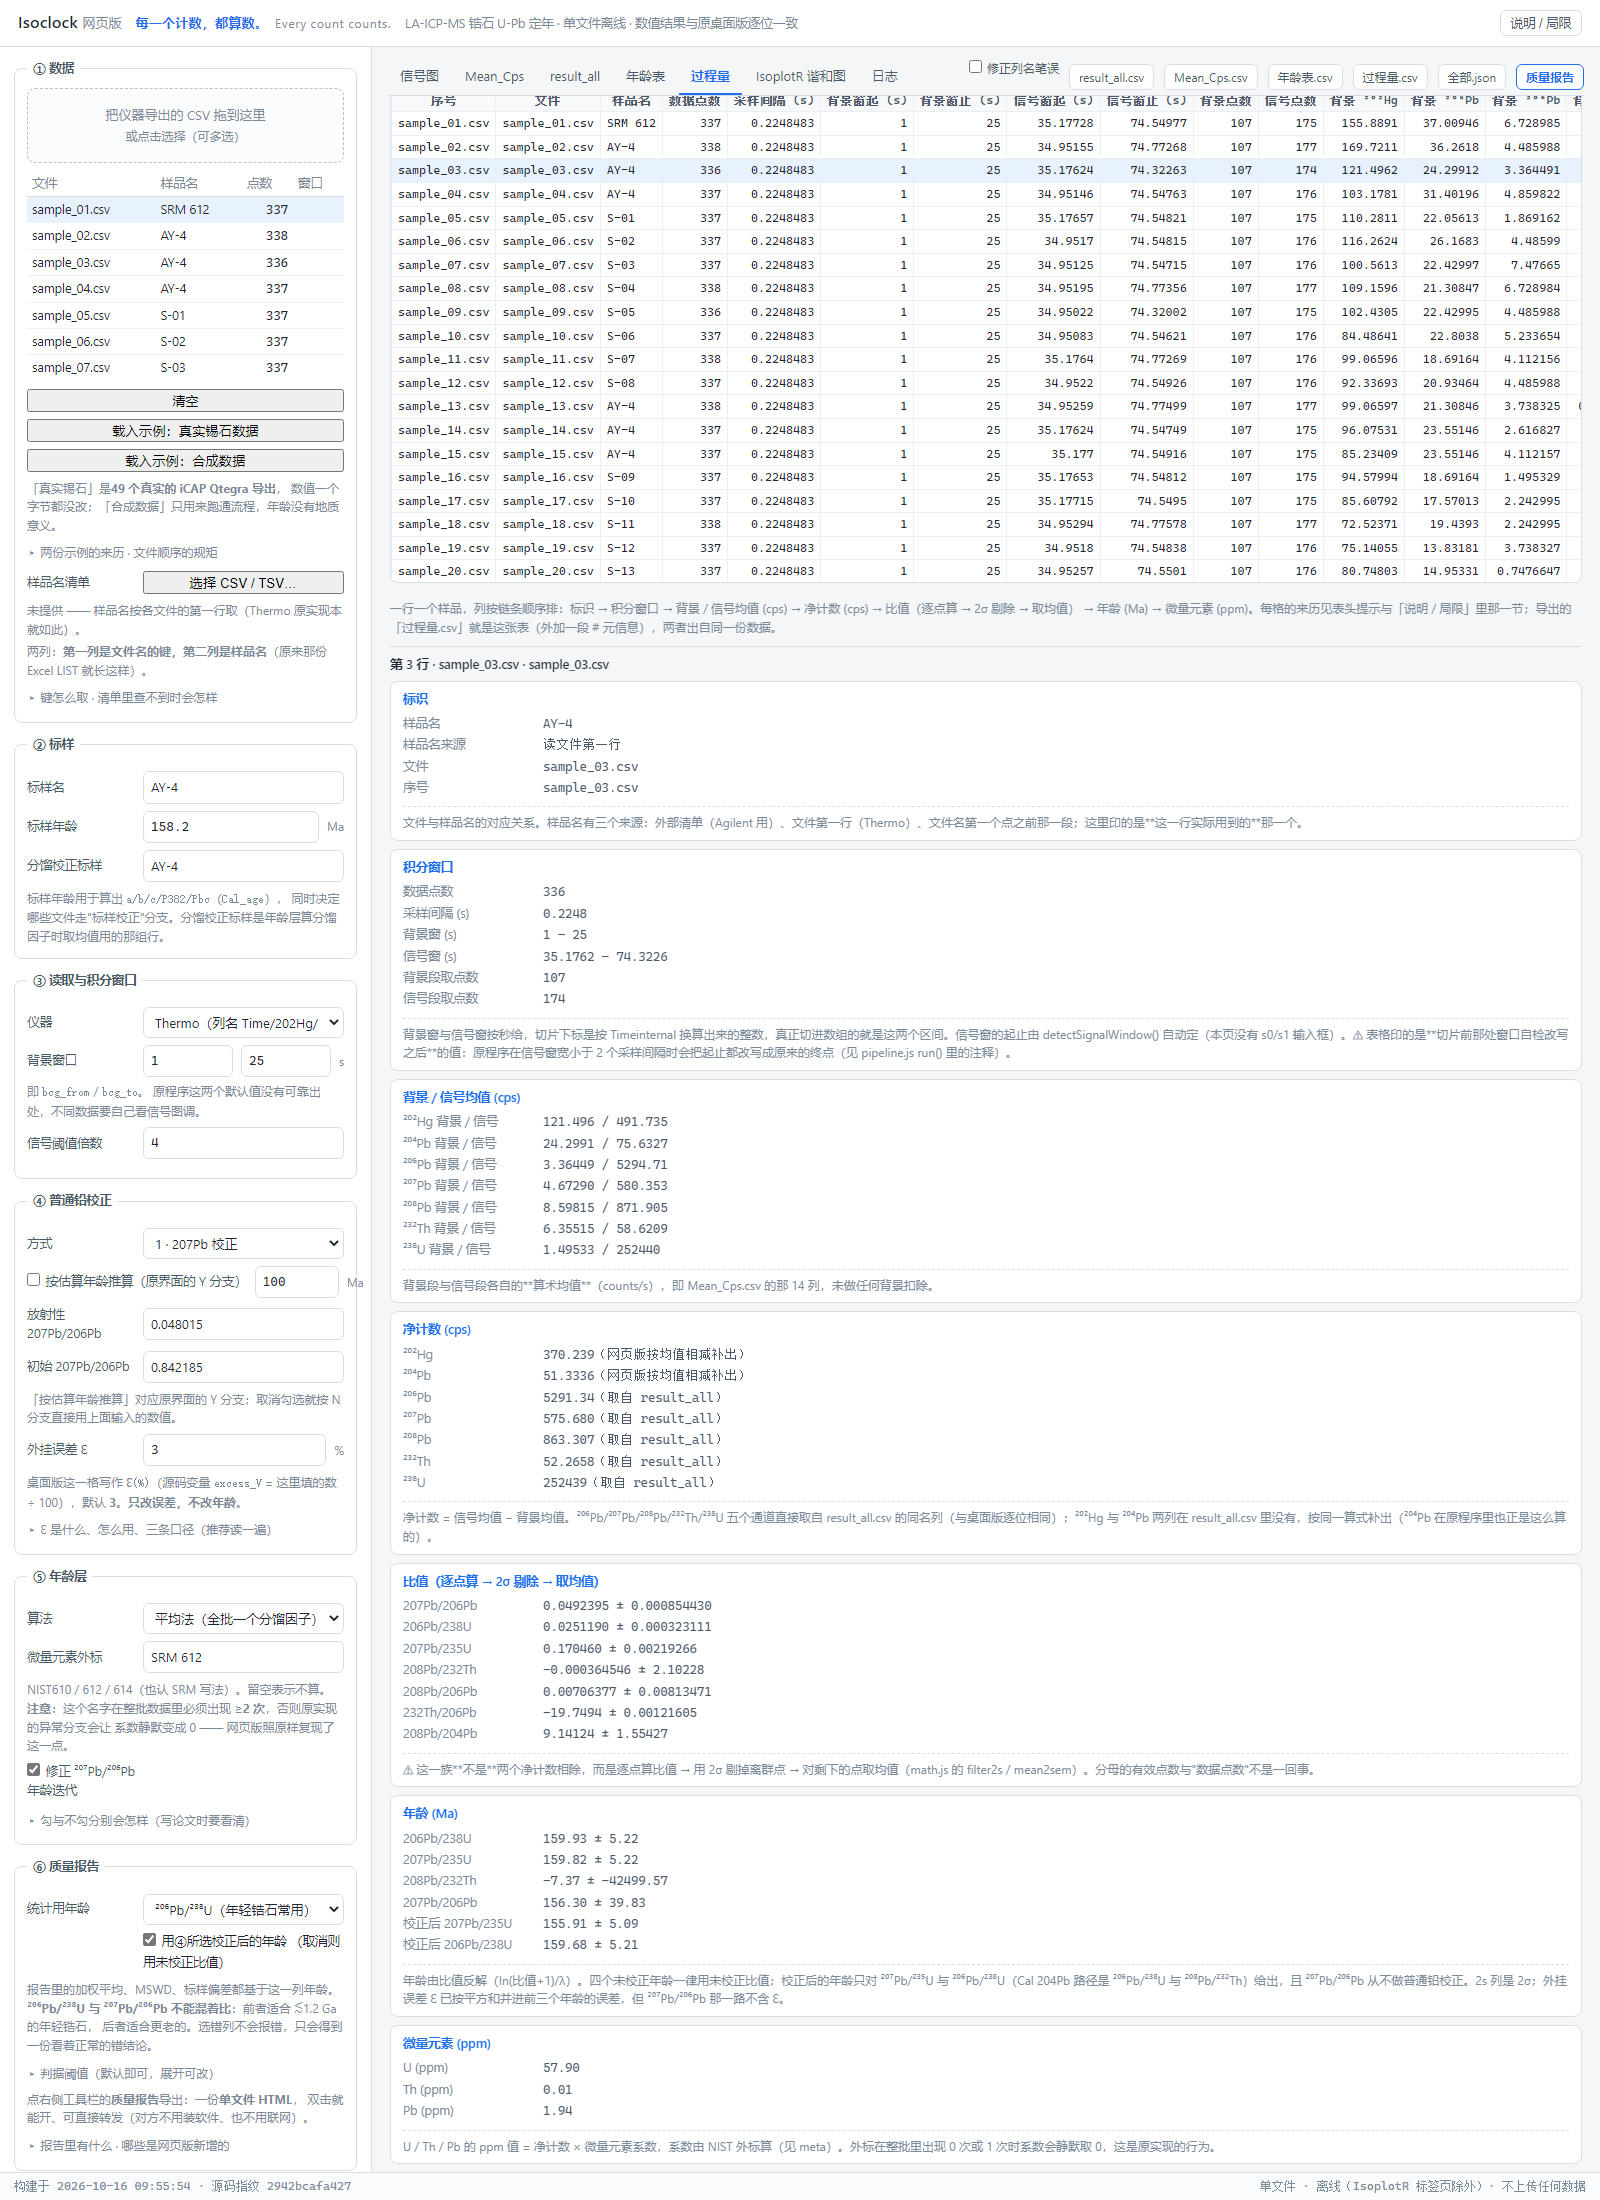
过程量.csv 新增
一段一段给你看中间数:积分窗口的下标、背景与信号均值、净计数(信号−背景)、 各比值与 2σ、分馏因子与校正系数、校正前/后的年龄。界面里也有对应的「过程量」标签页, 点任意一行能展开这一个样品的完整流水账。
per-stage intermediates
一句话定位
Isoclock 不是"又一个锆石软件"。它面对的是普通铅含量不可忽略、且各点还不一样的矿物。 这类样品里,普通铅处理得好不好,直接决定年龄可用不可用——所以它的核心是四条普通铅校正路径, 而不是锆石流程里的那些常规步骤。图解第 2 章用误差传递把这件事量化了。
这个分支改了什么Changes in this fork
先说清楚归属
软件与科学方法都是 Guoqi Liu 的(East China University of Technology, sndjgm@foxmail.com),上游仓库 sndjgm/Isoclock,Apache-2.0。 这里是一个 fork,没有改动任何一条科学逻辑。 如果你要引用方法或结果,请引用原作者与他的软件。
A. Python 桌面程序的工程整理
这些改动已经在上游之上提交,每一条都做了逐位/逐字节对照, 目的是让安装、运行与排错更顺——输出数值一个都没动。
| 改动 | 结果 |
|---|---|
| 5 个重复的还原函数合并成一个共享骨架(净减约 500 行) | 行为逐位相同:6 样品 × 5 路径 × 23 列 = 690 个输出格全部一致 |
loaddata 只按 float 读取需要的 8 列 |
39.0 → 9.5 ms/样品(4.1×) |
requirements.txt 收敛到真正需要的包 |
全新环境下 pip install -r 一次装通 |
| 许可文件补全为 Apache 2.0 全文 | GitHub 与 Zenodo 能正常识别许可证 |
| 转换脚本的输出名改用字符串处理生成 | 不再把文件名里的字符串当作代码执行 |
except 块补上 traceback;接管 Tk 回调异常(27 + 1 处) |
运行中的失败可见,打包成 .exe 后同样可见 |
| 删除 10 个未使用的 import | 不再为无用代码拉入 pyDes、openpyxl、base64 |
重写 README + 新增 CITATION.cff |
快速开始按当前仓库与说明书对齐,并补上说明书里有、README 里没有的关键前提 |
Isoclock2.0.py 从 4099 行降到 3676 行(−10.3%)。
桌面版的维护状态
以后主要更新网页版。Python 桌面程序(Isoclock2.0.py 与
packaging/)转入只维护、不加新功能:它留在仓库里、照常能用、照常出
Windows / macOS 安装包,数值输出仍然是网页版逐位比对的基准;但新的标签页、
新的导出、新的读取器一律只做在网页版这边。
两侧共用同一条数值链 —— 凡是会改动数字的改动,两边一起改,对不上就构建不过。
本页徽章里"与桌面版逐位相同"这句话,就是这条约定的产物。
B. 新增:一个纯浏览器的单文件网页版
把数值内核移植成 JavaScript,打包成一个 HTML 文件。没有后端、没有依赖、 不需要装 Python——双击就能用,可以直接当附件发给同行。
| 能力 | 状态 |
|---|---|
| 数值内核(成对求和、nanmean/SK2model、15 条还原路径、年龄层) | 与桌面版逐位相同 |
| Thermo 读取 | 严格匹配 + 兼容匹配两条路径 |
| Agilent 读取 + 端到端链路 | 已修好并加了反向哨兵 |
| 积分窗口自动识别 | 与桌面版一致 |
| 两个 CSV 的输出排版 | 逐字节相同 |
| 批次质量报告(新功能) | 单文件 HTML,七节,见下 |
| 谐和图 / 谐和年龄 / discordia 交点(新功能,可选) | 接 IsoplotR:全软件唯一需要联网的一页,见下 |
Element .fin |
不支持(专有二进制,请用桌面版转换) |
标样漂移回归 regression() |
仍未接线(上游本来就没有控件能触发它) |
新增的「批次质量报告」
跑完一批数据之后,最要紧的问题不是"年龄是多少",而是"这批数据能不能用"。 桌面版只输出逐点年龄、从不做归组统计,所以这一步补在网页版里: 点一下按钮,导出一份独立 HTML,把这些事一次说清。
标样 QC
每个标样测出年龄与真值偏差百分之几、内部一致性 MSWD 是多少、 哪几个点被判为离群。判定一定跟着理由——"偏差 0.0000% 但内部 MSWD 高达 325" 这种情况只印一个黄灯,读的人会以为没问题。
样品结果汇总
按样品名归组,给出加权平均年龄 ± 误差、MSWD、参与点数, 配一张手绘的内联 SVG 误差棒图(标样蓝色、样品青色、真值红色虚线)。
参数与判据都列清楚
报告里列全 16 个参数:是什么、在原程序里叫什么、本次取值、默认值与出处。 没有可靠出处的那两个默认值会直接写出来,不假装有依据。
四个判据阈值可改
标样偏差 ≤2%、MSWD ≤ 1+2√(2/(n−1))、单点 2s 相对 ≤10%、离群 |z| ≤3。 界面里可改,报告会标出「已改」。
必须说清楚的一条
加权平均、MSWD、以及上面四个阈值,都是网页版新增的,不是原程序的输出。 报告里每一节都重复声明了这一点。统计量按 Wendt & Carl (1991) / Isoplot 的定义手算, 检验用的判据是在测试里按定义另写一遍的独立值,不是拿自己的实现比回去。
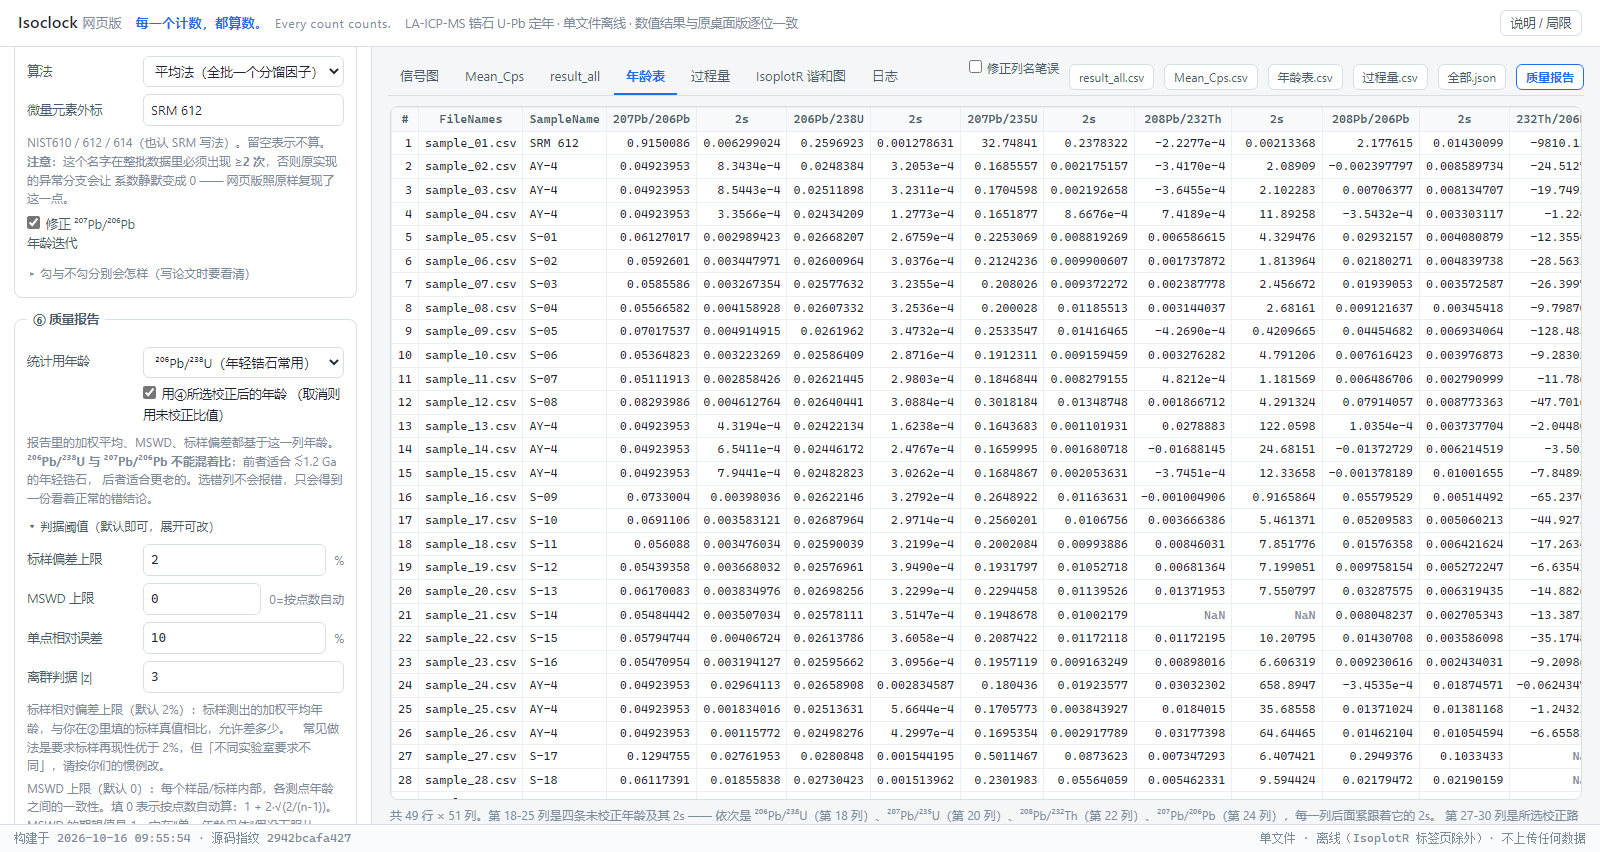
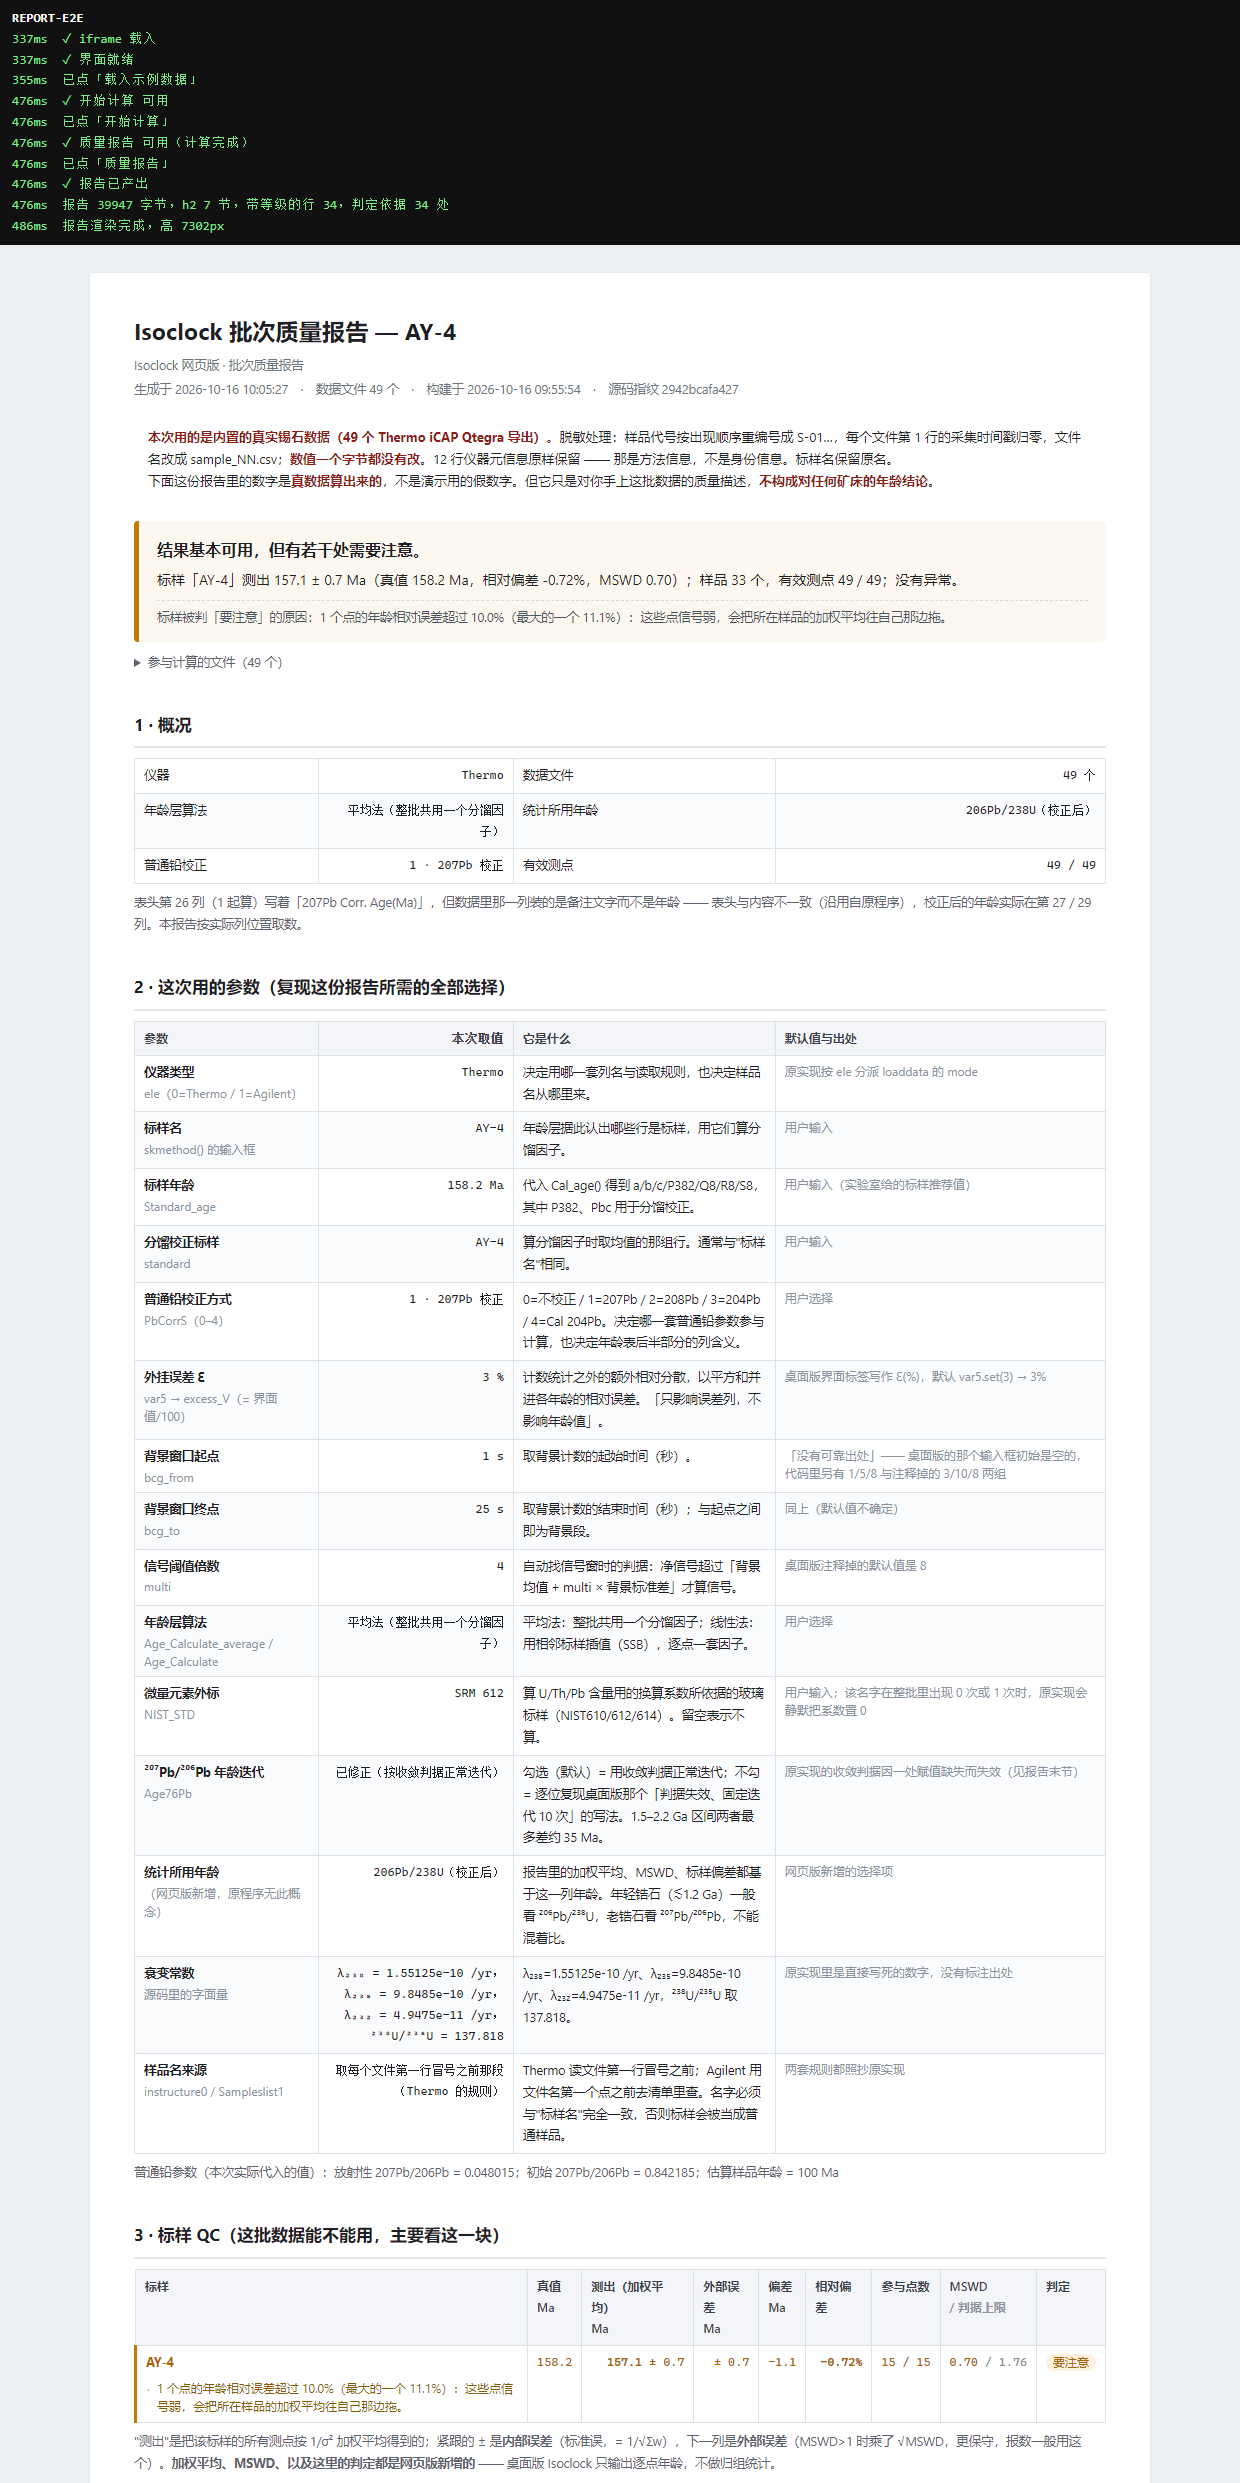
Ctrl+P 能直接存成 PDF。注意最上面那句话:加权平均 / MSWD / 阈值都是网页版新增的,
不是原程序的结论。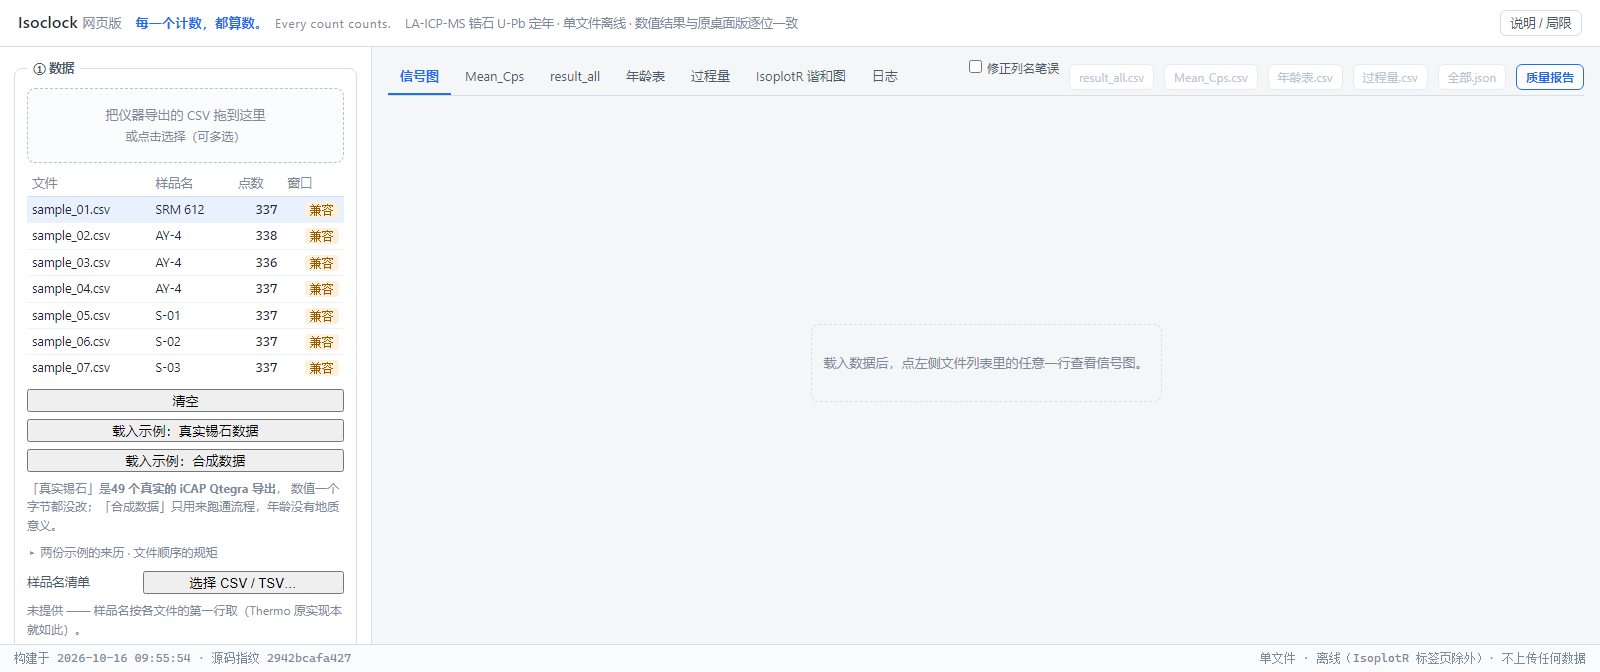
新增的「IsoplotR 谐和图」(可选,需要联网)
上面那些都是"数"。但要判断铅丢失与普通铅,最后还是得看一张谐和图 —— 而那正是这个软件最该交代的东西。自己把 Ludwig(1998) 的 discordia 拟合、 谐和年龄的最大似然估计重写一遍并不现实(那恰恰是 IsoplotR 十几年积累的地方), 所以这一页把 IsoplotR 接了进来:Pieter Vermeesch 的 R 语言年代学工具箱, U-Pb 领域的通用参考实现。
接口是 webR(编译成 WebAssembly 的 R)。点一下按钮,浏览器才去 CDN 取 R 运行时与 IsoplotR 包,装完就在本页内存里跑真的 R —— 数据不出本机。 代价是这一页要联网,首次约 16 MB、约一分钟,之后走浏览器缓存。 不点它,一个字节都不会下载,页面其余部分仍然是那份离线单文件。
图出来以后能存成什么。两个出口,都是矢量:「另存 SVG」是屏幕上这一份;
「另存 PDF」是让 R 用它自己的 pdf() 设备、拿同一份数据与同一份参数
再画一遍 —— 不是把屏幕上的图截下来塞进去,所以那份 PDF 里一张位图都没有,
文字是真正的文本对象(PDF 标准字体 Helvetica / Symbol),在 Illustrator、Inkscape、
Affinity 里能直接改字、挪图例、换线型,拿去拼图排版或投稿都行。
两份图各自跑一次拟合,所以界面会核对两次回来的数值是否逐字节相同;
对不上就把有差异的项列出来,不默默给一份与屏幕上不一样的 PDF。
图上的点应该是「样品」,不是标样。内置这批示例是一个文件一个测点: 其中两个名字是标样(U-Pb 分馏标样 AY-4 与微量元素外标 SRM 612,它们的文件数 比任何一个样品都多),其余每个样品只有 1 个测点。于是"按点数排序"会把 AY-4 顶到最前面 —— 而它是用来做 QC 的标样:它的年龄要拿去跟②里填的真值 (本示例 158.2 Ma)比,检验这一批的分馏校正与再现性, 不是待测样品的年龄。所以样品下拉里默认那一条是 「全部样品(不含标样,括号里是界面按当前结果现算的可用点数)」 —— 谐和线/不一致线该看的正是这些样品测点;两个标样被收进下拉最后那个分组 「标样(QC 用,不是样品年龄)」,想单独画它们、看它们落不落在谐和线上就点那一条, 界面会把拟合结果与②里的真值并排摆出来。单看数字是发现不了这个错的 —— 拿 AY-4 拟合出来的谐和年龄数值上完全正常,错的是"这些点是什么"。
两种图型
Wetherill(横轴 ²⁰⁷Pb/²³⁵U、纵轴 ²⁰⁶Pb/²³⁸U)与 Tera-Wasserburg(横轴 ²³⁸U/²⁰⁶Pb、纵轴 ²⁰⁷Pb/²⁰⁶Pb)。 四种普通铅处理(不校正 / 固定比值 / 等时线截距 / Stacey–Kramers) 只在图上做投影,不改任何年龄数值。
三种拟合
只画图、谐和年龄(concordia age)、discordia 交点 (三种权重口径,含过离散项)。年龄、1σ、95% 置信区间、MSWD、p 值、自由度 都在图下面列出来 —— MSWD 是判断点是不是真在一条线上的唯一依据。
两个必须说清楚的坑(都是实测撞出来的,不是设想)
① 三个口径不要直接对着比。本软件年龄表里的 2s 是 2σ;
IsoplotR 汇总表里的 1σ 是 1σ 标准误;而画在图上的是
95% 置信区间(≈1.96σ)。三个数差一倍到两倍,混着看会得出错误结论。
所以这一页把它们并排列出时,每一行都带着自己的口径字样。
② ρ 的判据必须作用在"真正写出去的那个数"上。年龄表里的相关系数
rho 最高可以到 0.99999999999999889,而交给 IsoplotR 的文件是
按 10 位有效数字写的 —— 那个值写出去恰好是 1,协方差矩阵随即退化,
IsoplotR 会只报一句 L-BFGS-B needs finite values of 'fn' 就撂挑子。
现在这类点在界面上会点名剔除并写出原因与文件名,而不是让它悄悄把整次拟合弄坏。
这不是数据坏了 —— 是原实现里那个 min(|t|, w/s) 夹逼在相对误差相当时
饱和到 1,年龄表也照印。有意思的是:内置示例里命中这条的两个点都是标样 AY-4 的
(所以默认那个"全部样品"视图里一个都不用剔,只有你专门去画 AY-4 才会看到提示)。
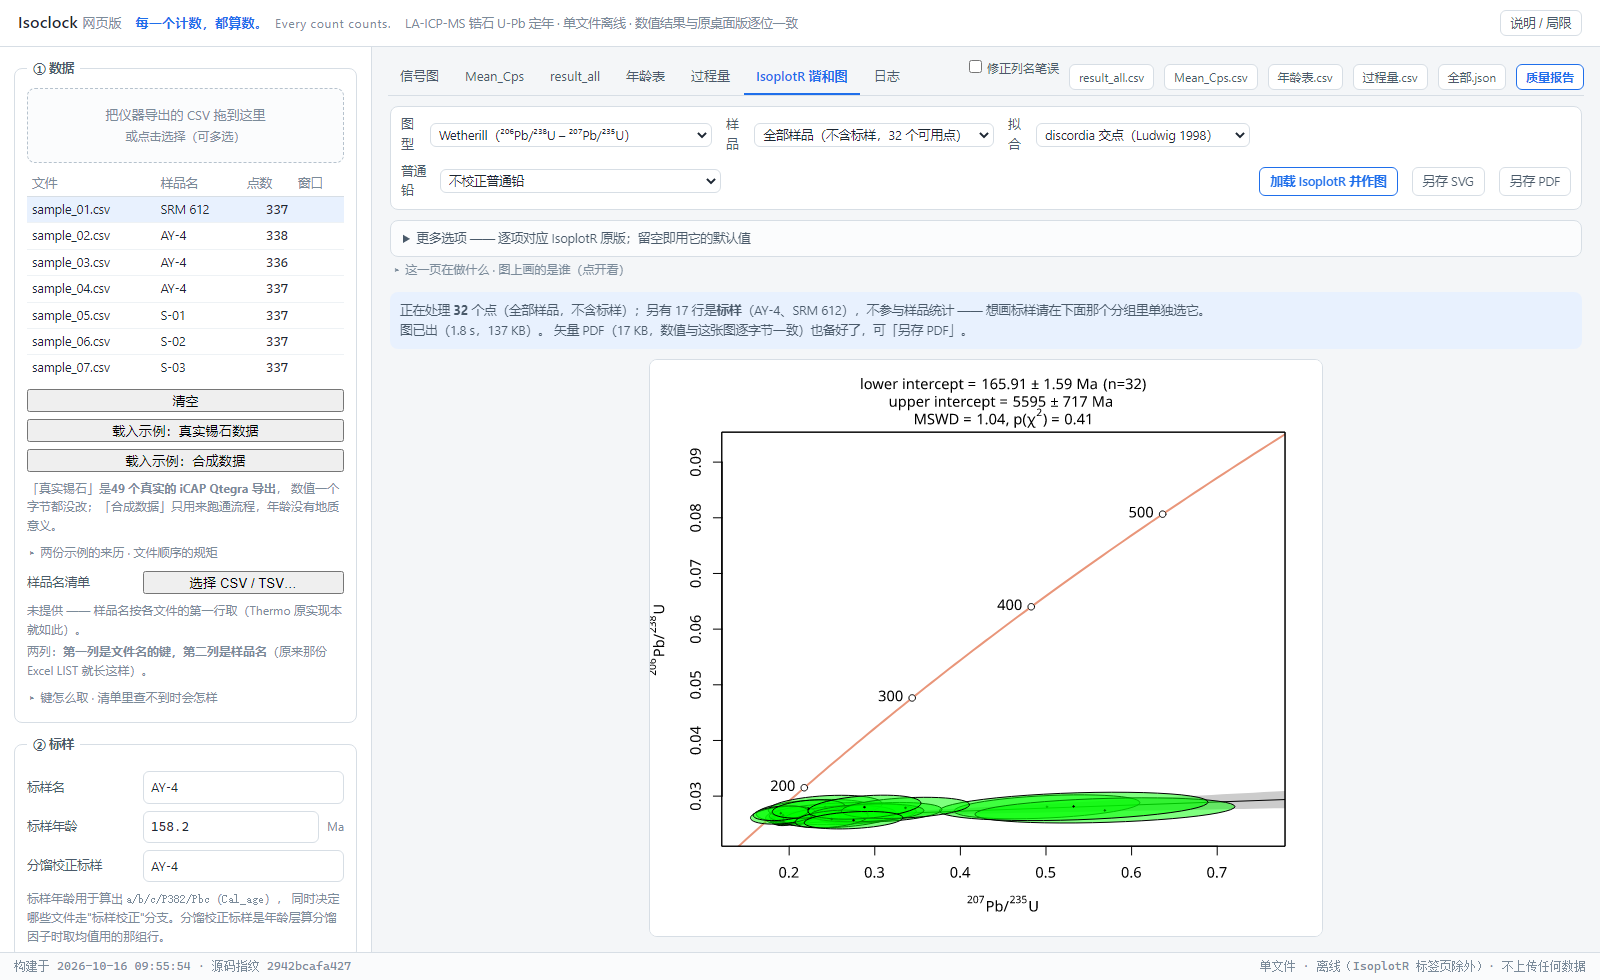
1σ 是 0.813 —— 两个数差一倍,这就是本页反复提醒的三联口径)。
消息条同时报了两件事:另有 17 行是标样(AY-4、SRM 612)不参与样品统计、
以及"想画标样请到下面那个分组里单独选它"。作为对照:同一批点若改选"谐和年龄",出来的是 170.83 Ma 而 MSWD 604 —— 这就说明这批锡石本来就不谐和(普通铅高),该看的是交点年龄而不是谐和年龄。 这些数就是这次实拍的结果,出处是
webgui/screenshots/ 里那张图本身;
重拍一次它们就会换一组,所以别把这一段当成"本软件算出来的定值"。
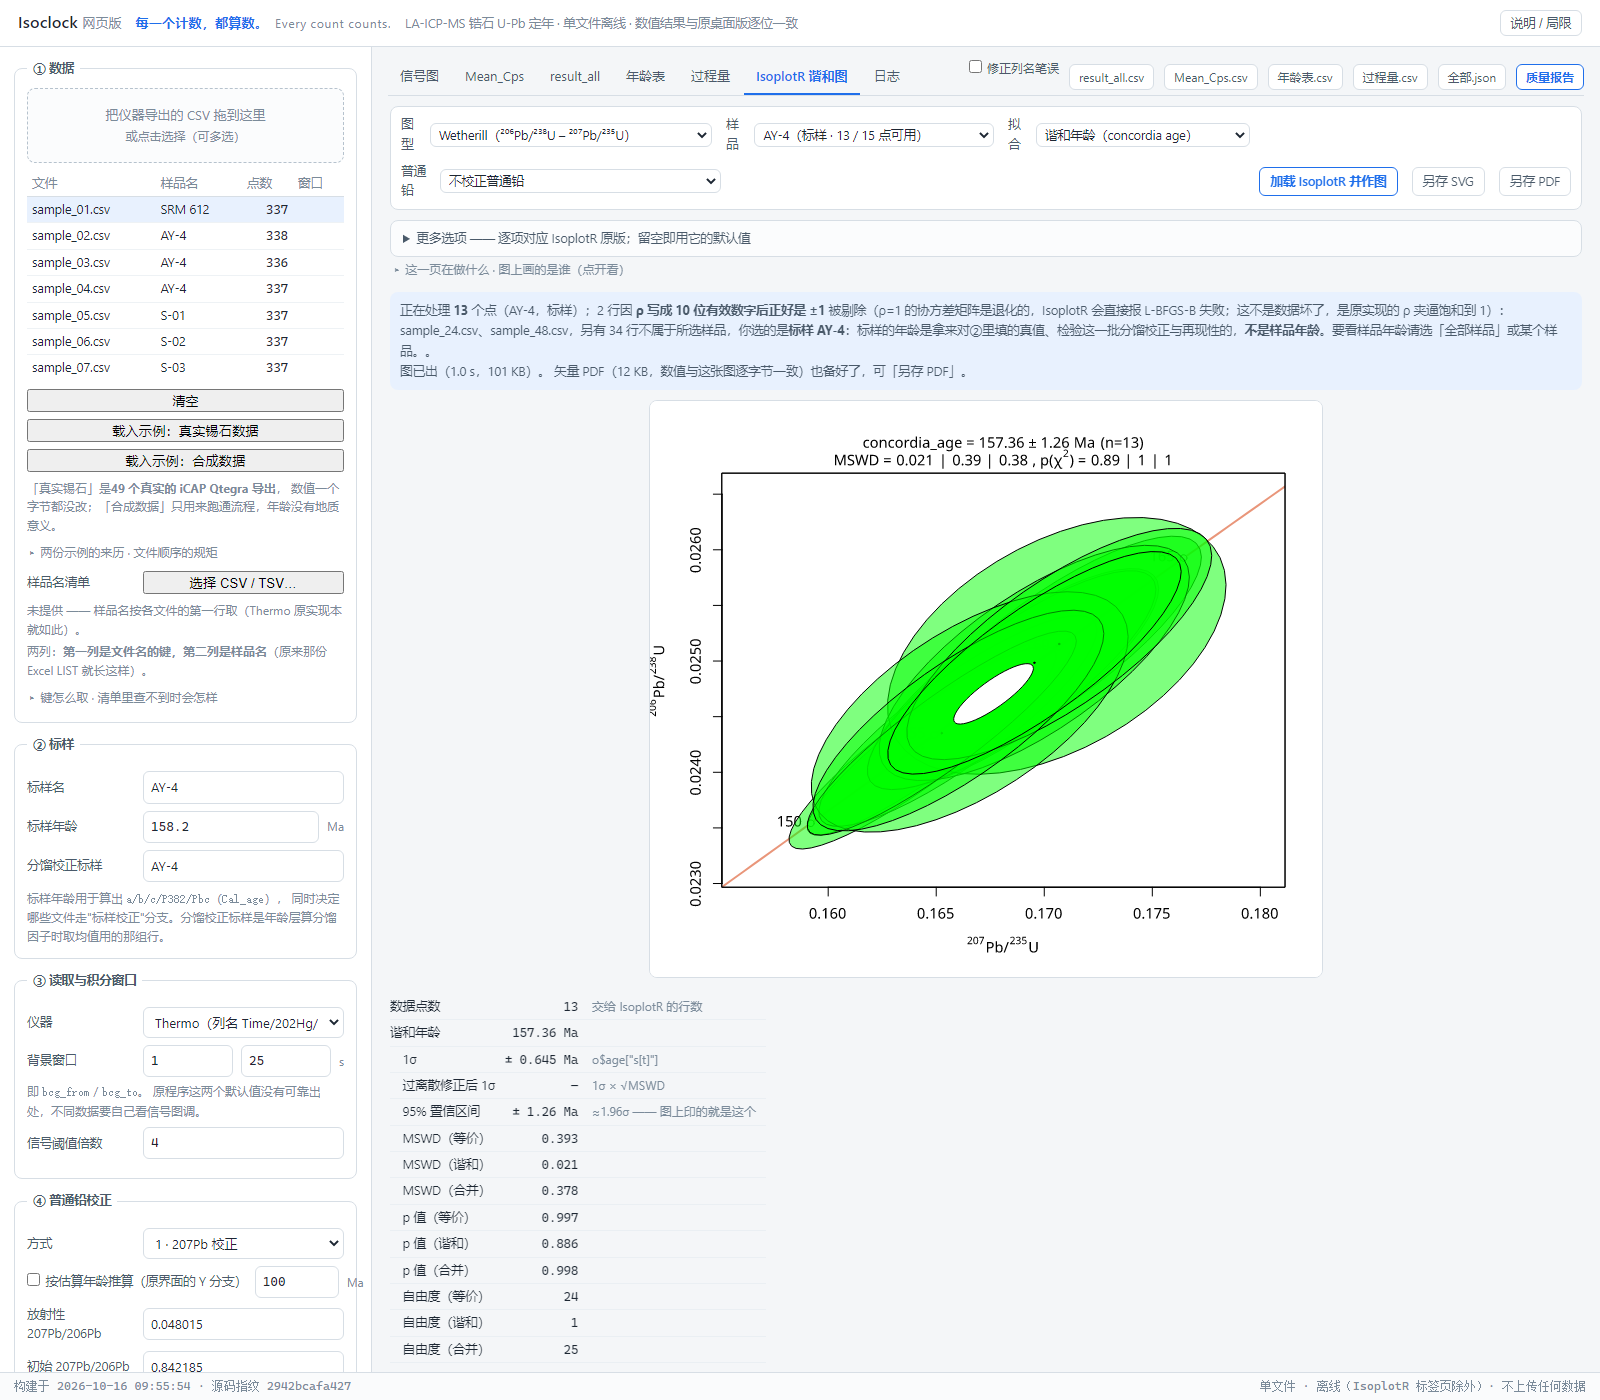
webgui/test_isoplotr.js 的 §G 里,
每次构建都会重跑。为什么标样要单独摆出来:它是 QC 样,年龄要跟真值比;而"样品年龄" 是上面那张图的事。把标样混进样品里拟合,数值上完全正常(照样出一串漂亮的 年龄与 MSWD),错的是"这些点是什么"—— 这正是这一版专门把两者在下拉里分开的原因。
「更多选项」:逐项对齐 IsoplotR 原版
四个主下拉之外,这一页还收着一组默认折叠的「更多选项」面板。里面的控件是
逐项照抄 IsoplotR 自己的图形界面(pvermees/IsoplotRgui 的
inst/www/options/concordia.html)的:锚定 anchor
(含"强制交点落在指定年龄")、不谐和度过滤 cutoff.disc
(判据 5 档 + 上下限)、年龄与坐标范围 tlim / xlim / ylim、
谐和线刻度 ticks、有效数字 sigdig、
误差椭圆样式与点号、以及计入衰变常数误差 exterr。
参数名、取值、默认值都照抄,不自己发明。两条规矩值得写下来:
① 留空就是不传那个参数 —— 让它用 IsoplotR 自己的默认值,而不是另编一个。
所以什么都不碰时,行为与没有这个面板时逐字相同(这条有断言钉着)。
② 界面上来的东西一律不当代码执行 —— 只有过校验的数字、受控布尔和
正则校验过的 #RRGGBB 颜色能进 R 脚本,别的字符串一概丢掉;
该填数字的地方填了非数字会直接报错,不会悄悄退回某一档。
每次作图之后,真正传进 R 的那串参数会原样印在结果下面(并进日志),
这样一张图配一行参数,别人能照着复现。上面两条做不到的项也写在面板里,
原因见文末「局限」那一条。
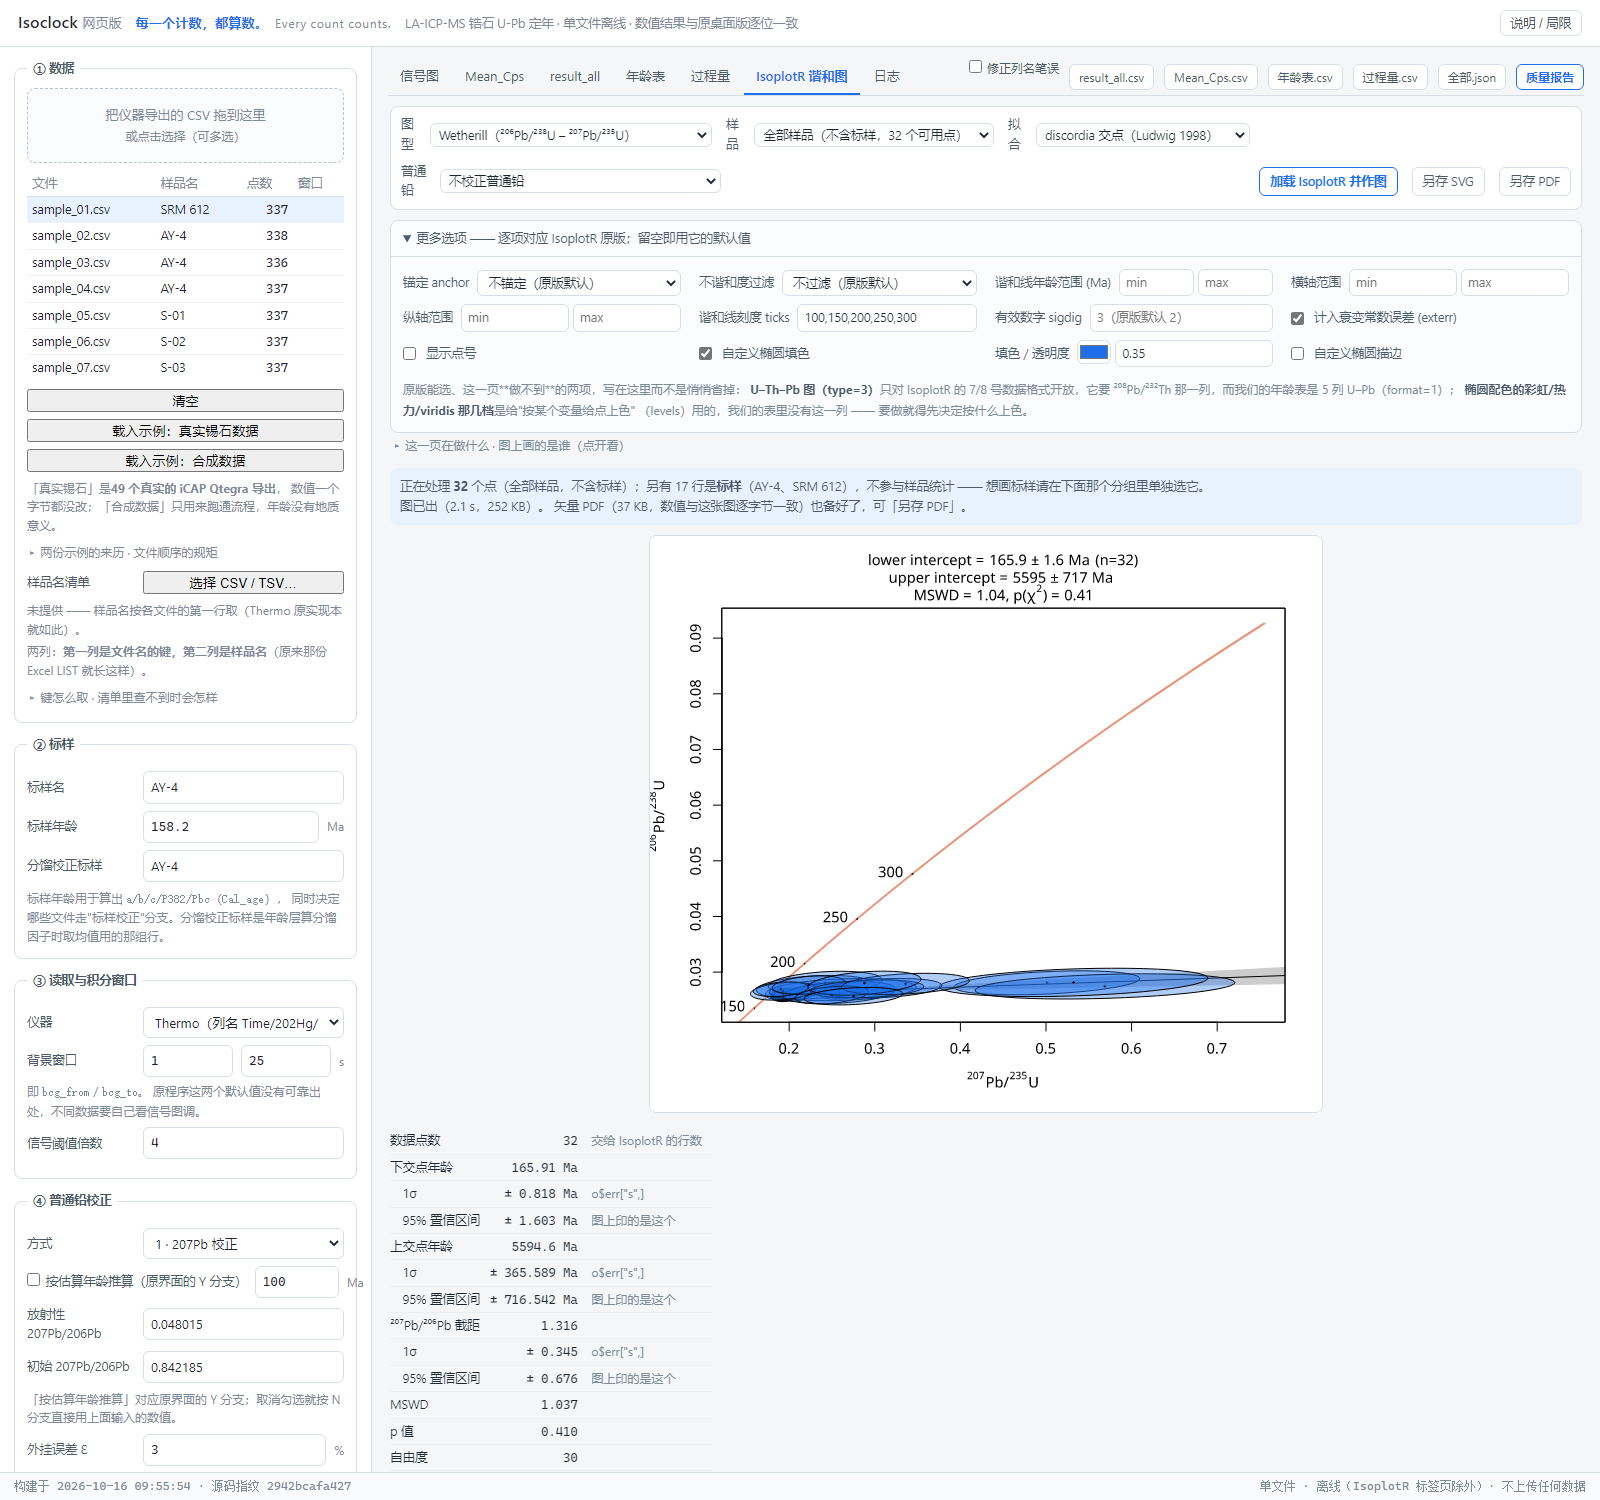
ticks=100,150,200,250,300、
勾了计入衰变常数误差、并把误差椭圆改成自定义的蓝色与 0.35 透明度)。
注意联动:因为锚定选了"不锚定",所以「锚定年龄」那一格根本没出现;
不谐和度过滤没开,判据与上下限两格也收着;描边色没勾"自定义"就同样不显示 ——
看不见的控件不会被读进参数。用不到的先收起来(而不是画面上摆一堆灰的),
与前面几个标签页的做法一致。图下方那行是这次真正传给 IsoplotR 的实参表,印出来只为了一件事: 结果要能复现,光有图不够。
三种拿法Three ways to get it
同一套内核 —— 后两种装的都是同一份 isoclock.html。
按"要不要装东西"排,最省事的是什么都不装。
单文件网页版
一个 isoclock.html,986 KB。下载后双击,
用你现有的浏览器打开就能用。不装 Python、不装依赖、不联网 ——
样式和图都在这个文件里面。唯一例外是可选的「IsoplotR 谐和图」标签页:
那一页点了按钮才会去 CDN 取 R 运行时(见下),不点就一个字节都不下载。
为此涨到 986 KB 上下是故意的:里面内嵌了 49 个真实的锡石 LA-ICP-MS 导出(压缩后 338 KB),所以开箱就能拿真数据跑一遍完整流程, 而不是只能看合成出来的假计数。一个网页 986 KB 仍然比一张手机照片小。
Windows / macOS / Linux 通用,只要那台机器有浏览器。
桌面程序 .exe
单个 .exe,约 10 MB(Windows 上实测 9.8 MB、CI 构建约 12 MB,
随打包用的 Python 版本略有出入)。
双击就是一个真正的程序窗口:有图标、
没有地址栏,导出走系统的"另存为",文件名和扩展名都是对的。
需要 Windows 10/11。用的是系统自带的 WebView2 运行时 —— 一般都有;确实没有的话装一次即可(免费,约 2 MB)。
桌面程序 .app
同一个窗口程序的苹果版,Apple Silicon 与 Intel 各一份。
解压后把 .app 拖进「应用程序」就行(解压后约 54 MB)。
第一次打开请右键 → 打开。产物只有 ad-hoc 签名(苹果的开发者签名 要年费),Gatekeeper 会拦一次;右键放行一次之后,正常双击即可。
这个程序的读者很可能一年只用两三次,而且常常是在别人的电脑上、 或者实验室那台不让装软件的工作站上。对这种用法,"下载一个文件、双击打开" 比"装一个程序"合适得多 —— 用完可以直接删掉,什么都不留下。
桌面程序存在的理由只有三条:真正的应用窗口、导出走系统原生"另存为"、
macOS 上能进「应用程序」。它算的还是同一份网页版 ——
壳里没有一行数值代码,只是把 isoclock.html 装进系统自带的
WebView(Windows 用 WebView2,macOS 用 WKWebView)。
但桌面版已经进入只维护状态:它照常能用、照常出安装包,数值仍是网页版 逐位比对的基准;新标签页、新导出、新读取器一律只做在网页版 (见这个分支改了什么)。
三个平台各由一台对应系统的构建机产出 —— 因为 PyInstaller 不能 交叉编译:Windows 的 exe 只能在 Windows 上构建,macOS 的 app 只能在 macOS 上构建。苹果那份必须在苹果的机器上出,这是没法绕过的。
每次构建分两步把关:先跑 561 项数值比对(webgui/test_*.js,
16 套,与桌面版逐位对照),再把产物本身启动一次、跑页面内自检
(94 项,走的是真按钮那条路)。任一步不过就不发布。
网页版怎么用Using the browser version
不需要安装任何东西。打开页面,左边填参数,右边看结果。
Isoclock 这个名字就是
isochron + clock。约 1.4 s 自动淡出,点一下、按任意键、滚一下滚轮都立刻进入;
它不写任何本地存储、不联网,所以每次打开的行为都一样。
不想要它:给地址加 #nosplash 即可完全跳过。- 左侧 ① 数据把一整批原始文件拖进去(或点选)。文件列表会逐个显示解析状态。
- 左侧 ② 标样填标样名称与它的真值年龄——标样年龄是后面所有普通铅参数的来源, 填错会一路错到底。
- 左侧 ③ 仪器与积分窗口选 Thermo 或 Agilent。窗口可以自动识别,也可以手填。
- 左侧 ④ 普通铅校正选校正方式。想要看校正前的原始比值就选"不校正"。
- 左侧 ⑤ 年龄层选年龄计算方法、外挂误差 Ɛ、算法(平均法/线性法)。
- 右侧点「开始计算」。之后在七个标签页里看信号图 / Mean_Cps / result_all / 年龄表 / 过程量 / IsoplotR 谐和图 / 日志,或者点工具栏的质量报告导出那份 HTML。 拿不准某个年龄是怎么从计数变出来的,就翻过程量那一页 —— 它把 积分窗口、净计数、比值、分馏因子、校正系数逐段摊开,每行点开是单样品的流水账。 IsoplotR 那一页是可选的:要用到谐和年龄或 discordia 交点才需要打开它, 而且它要联网(其余六个标签页全离线)。
不确定就用内置示例
左栏有两个示例按钮,点下去连参数一起配好——先看一遍完整的输出长什么样, 再拿自己的数据进来。
「载入示例:真实锡石数据」是 49 个真实的 Thermo iCAP Qtegra 导出
(锡石 LA-ICP-MS U-Pb,一次连续会话:首尾各夹着一个标样 SRM 612)。
它不是挑出来的"干净"数据:有信号很弱的点(最弱的净 ²⁰⁶Pb 只有 150 cps,
不到本批中位数一半的有 16 个)—— 这些都会在日志里点名说清,
质量报告会把它们剔除而不是拿去污染平均。所以你可以拿它当一次真实的练习:
看程序怎么处理一批不完美的数据。
这批里还有 4 个文件的信号段前面挂着一个单点噪声尖峰:只按阈值穿越定
积分窗口时,会把这个尖峰当成信号段,窗口塌缩成零点几秒、整行比值算不出来。
网页版在选窗口前先剔掉持续时间过短的段,这 4 个文件于是都能算出结果
(webgui/src/window.js,对照用例见 webgui/test_window.js)。
脱敏处理只有三件事:样品代号重编号成 S-01…、每个文件第 1 行的采集时间归零、
文件名改成 sample_NN.csv;数值一个字节都没有改,
12 行仪器元信息原样保留(那是方法信息,不是身份信息)。标样名保留原名。
唯一少掉的是一个文件:批次最开头那一次采集是前一天的孤立信号
(总行数与驻留时间都和这批不是一套设置,净 ²⁰⁶Pb 只有全批最弱的零头),
按数据主人的判定剔除 —— 内嵌的这批是 49 个,比原始目录少这一个。
剔除规则与复核方式写在 webgui/make_real_demo.py 里。
顺带把数字摆出来:它的标样 AY-4 按内置参数跑出
157.1 ± 1.4 Ma(2σ,MSWD 0.70),与两个公开发表的 ID-TIMS 值
(158.2 ± 0.4 Ma、151.9 ± 2.2 Ma)都对得上 —— 这正是
webgui/test_demo_real.js 里那条判据。
「载入示例:合成数据」是另一条路:人为拼出来的计数,只用来演示版面。 它不满足 U-Pb 体系关系,出报告时顶部会挂一块红色声明确认这件事。
为什么是单文件,而不是"网页部署 + 后端"
因为这个软件的使用场景是:一台装了仪器的电脑、一个不能上网的实验室、 一份要发给合作者的数据。要求使用者去装 Python、再起一个服务,是把人挡在门外。 一个 HTML 文件可以走邮件、走 U 盘、走任何一台电脑的浏览器,十年后还能打开。
代价是全部计算跑在浏览器里,几十个文件没问题,上千个文件会慢。 真要跑大批量,用桌面版。
| 项 | 桌面版(上游) | 网页版(本分支) |
|---|---|---|
| 安装 | Python 3.9 + 依赖 + Tk | 不用装,双击 HTML |
| 仪器支持 | Thermo / Agilent / Element | Thermo + Agilent(Element 请用桌面版转换) |
| 数值结果 | 逐位相同(唯一残留:exp/log 列 ≤8.6e-11 的相对偏差) | |
| Agilent 样品名 | 弹窗选 Excel 清单(xlrd) | 选两列 CSV/TSV;不选则取文件名第一个点之前 |
| 批次质量报告 | 无 | 新增,独立 HTML |
| 谐和图 / 谐和年龄 / 交点年龄 | 无 | 新增(可选):接 IsoplotR,需联网 |
| 批量性能 | 好 | 几十个文件没问题,上千个会慢 |
| 文件状态 | 每批跑完要重启程序 | 刷新页面即可 |
把原理讲清楚Understanding the method
这个仓库里还有一份中文图解教程:8 章、56 张手绘 SVG 图, 从"U-Pb 定年的三条腿"讲到代码地图。它假设你完全不懂, 并且明确写出哪些地方是猜测、哪些地方有更好的做法。
第 1 章 · 三个计时器
²³⁸U→²⁰⁶Pb、²³⁵U→²⁰⁷Pb、²³²Th→²⁰⁸Pb 三条独立的钟。
年龄公式为什么长成 ln(r+1)/λ,为什么单次测量能出四个年龄,
²⁰⁷Pb/²⁰⁶Pb 年龄为什么特殊。
第 2 章 · 分水岭
锆石结晶时把铅几乎全部排出,所以一条谐和线就够用; 磷灰石、白钨矿这些矿物会把普通铅包进去。图解用误差传递把"难多少"算成了数字, 而不是只给一句定性的说法。
第 3 章 · 普通铅说透
普通铅到底是什么、²⁰⁴Pb 为什么是它的指纹、为什么偏偏它最难测、 四条校正路径各拿什么当"比例尺"、Stacey–Kramers 两阶段模型怎么来的、 那些默认值凭什么这么设。
第 4–8 章 · 流程、说服力、局限、代码地图
从原始文件到年龄每一步在干什么;怎么让别人接受你的结果; 哪些地方承认是猜的、可以怎么改进;以及代码里哪个函数对应哪一步。
常被问到的两件事
「外挂误差 Ɛ」到底是什么?
界面上的 Ɛ(%)(代码里叫 excess_V,默认 3%)是
计数统计之外的额外相对分散:剥蚀效率波动、气溶胶传输损失、基体效应、
标样与被测样品不匹配、软件拟合残差——这些都没有体现在 2σ 里,用一个常数顶上。
它以平方和并进相对误差(sqrt((比值2s/比值)² + Ɛ²)再乘到年龄误差上),
不改变年龄值。
三处口径并存(原实现如此,照抄并说明)
① 内部相对误差用的是比值的 2s(2σ),而 Ɛ 直接与它平方相加——严格说混了置信水平; ② ²⁰⁷Pb/²⁰⁶Pb 年龄的误差不含 Ɛ,同一行四个年龄口径不一致; ③ 把 Ɛ 调大会让 MSWD 变小,所以不能用它去"改善"一致性。
「MSWD 超过多少算不合格?」
报告里的默认判据是 1 + 2√(2/(n−1)):χ²/(n−1) 的取样标准差近似 √(2/(n−1)),
超过"1 + 2 倍取样标准差"就值得看一眼。注意它是点位级的一致性指标,
与"这批年龄跟真值差多少"是两回事——两个都要看,见上面标样 QC 那张卡。
验证到什么程度,以及它的边界Verification & honest limits
这一节比上面都重要。一个定年工具最该交代的不是功能列表,而是 它凭什么值得信、它在哪儿不能信。
凭什么是逐位相同
参考值不是"把算法再抄一遍",而是用 importlib 加载真实的
Isoclock2.0.py(stub 顶掉 tkinter)算出来的。否则就成了
"拿我的实现验证我的实现"。
| 测试对象 | 覆盖规模 | 结果 |
|---|---|---|
| 成对求和 / nanmean / nanstd | NumPy 语义逐个复刻 | 逐位相等 |
| 数值内核(3 样品 × 5 路径 × 23 列) | 345 个输出数值 | 逐位相等 |
| 5 个还原函数 | 690 个输出格 | 0 处不一致 |
| Thermo / Agilent 解析 | 1400 个数值 | 全部相等 |
| 积分窗口识别 | 17 项 | 全部通过 |
dataprocess 端到端(4 路径 × 2 态) | 两份 CSV | 逐字节相同 |
| 年龄层(19 组参数 × 51 列) | — | 全部相等 |
| Agilent 端到端 | 20 项,含反向哨兵 | 全部通过 |
| 网页版统计(QC) | 63 项,判据按定义另算 | 全部通过 |
| 报告生成 | 50 项,含恶意输入转义 | 全部通过 |
| IsoplotR 接入层(新增) | 纯函数、不联网;逐套的项数由 docs/make_badges.py 与
app.html 里的 data-count 标记互核 |
全部通过 |
| 合计 | 561 项(16 套)+ 94 项页面内自检 | |
必须说出来的局限
真实数据这条待办:Thermo 侧已结清,Agilent 侧还没有
Thermo / iCAP Qtegra 侧已经用真文件验过了。
一批 49 个真实导出(锡石 LA-ICP-MS U-Pb)全部走严格读取路径,
并且整条链跑到底:标样 AY-4 出 157.1 ± 1.4 Ma(2σ),与两个公开发表的
ID-TIMS 值相容。这批数据已内嵌进网页版作为默认示例,
判据写在 webgui/test_demo_real.js 里,每次 CI 都会重跑。
它同时把两件事变成了机器可查的:脱敏没漏(样品名必须全在白名单内)、
内嵌数据没被换过(明文 JSON 的 sha256 逐字节核对)。
还没验的是 Agilent 的真实导出。Agilent 那条路径的判据到目前
仍是"合成变体",按"真实导出可能长什么样"设计。手上没有 Agilent 的真文件。
请把你遇到的读不进去的文件发出来,这是眼下最有用的贡献。
Element 的 .fin 也仍然需要桌面版先转换。
- 三项数值行为——会改变数值输出,所以一律按原样保留,只标注适用范围
(见 README 的
Notes for users):Age76Pb固定的 10 次迭代,在 1.5–2.2 Ga 区间与收敛解相差最多 +34.9 Ma;比值恰在起点附近时甚至会返回 0 或负年龄。PbCorrS == 3这条路径在 204 通道净计数为零时无法继续 (网页版对该行显式置 NaN,并在日志里报出行号)。- Hg 对质量 204 的校正未纳入(该项结果恒为 0)。
- 网页版把
Age76Pb做成了可切换的收敛修正,默认勾上 (按判据正常迭代);取消勾选则逐位回到桌面版数值。 这是本分支唯一可能让同一批数据给出不同数字的地方, 两个口径都随时可复现——分别对应"要正确"和"要和已发表结果对上"两个用途。 - 内置的"真实锡石"示例只有一批、且只来自一台仪器(Thermo iCAP Qtegra, 锡石 U-Pb)。它证明的是"真文件读得进去、整条链算得对", 不等于把各种仪器、各种矿物、各种导出格式都试过了。 合成那条示例则完全不满足 U-Pb 体系关系,只能用来熟悉界面。
- 普通铅模型是"平均猜测":Stacey–Kramers 是个全球平均模型, 具体样品未必服从。图解 3.8 节专门承认了这件事。
- 「IsoplotR 谐和图」那一页是外挂的,而且需要联网:出图与拟合全部由 IsoplotR(R 包,走 CDN 现装)完成,不是本分支的实现,也与桌面版无关。 它能出图不代表本软件会算谐和年龄 —— 那一页里没有一个数来自本分支的代码, 只有"交给它什么数据"这件事是本分支决定的。所以:两边的数不要互相印证 (口径本来就不同,见那一页下面的三联口径说明);真要引用方法, 请引用 Vermeesch (2018) 与 IsoplotR 本身。另外它用了 R 生态, 不在"零依赖、十年后双击还能开"这个承诺里 —— 那承诺只覆盖其余部分。
- ρ 写出去正好等于 ±1 的点会被那一页剔除(内置示例里命中 2 行,
而且都是标样 AY-4 的)。这不是数据坏了,也不是修出来的毛病:原实现的
rhoOf用min(|t|, w/s)夹逼,两个比值相对误差相当时 就饱和到 1,年龄表里也照印着这个 1。本分支没有改它(改了会变数值), 只是在交给 IsoplotR 之前把这类点挡下来并点名说明 —— 因为 ρ=1 的协方差矩阵是退化的,送进去只会得到一句L-BFGS-B needs finite values of 'fn'和一张空图。 - 标样不是样品。下拉里默认那条「全部样品(不含标样)」才是谐和图的 主体;两个标样(AY-4 / SRM 612)在单独的分组里,是给"这一批靠谱吗"用的 (拿它对②里的真值),不是待测样品的年龄。内置示例每个样品只有 1 个测点, 所以"只选某个样品"在图上就是一个点,拟合年龄没有意义 —— 要出年龄就选 「全部样品」。这条是领域口径,不是界面细节:拿标样当样品拟合出来的数 看着完全正常,只有知道"这些点是什么"的人能看出不对。
- 跟 IsoplotR 原版对齐时,有两项如实缺着。「更多选项」面板是逐项照抄
pvermees/IsoplotRgui的 concordia 表单的,但有两项这一页做不到, 所以写在面板里而不是悄悄省掉:U–Th–Pb 图(type=3)只对 IsoplotR 的 7/8 号数据格式开放(它要 ²⁰⁸Pb/²³²Th 那一列,而这里的年龄表是 5 列 U–Pb);不谐和度过滤的第二档(按普通铅校正后的比值过滤) 要求数据格式 ≥4(得有逐点的普通铅校正量);椭圆配色的彩虹/热力/viridis 那几档是给"按某个变量给点上色"(levels)用的, 这里的表没有这一列。要做就得先决定按什么上色。
已知的上游问题(本分支未动)
- 状态文件
Time_setting.npy/Coments.npy用的是 CWD 相对路径 +allow_pickle=True。原作者可能是有意让每批数据各带一份积分窗口设置, 改成全局目录反而会破坏这个功能,所以保持现状。 - 输入目录与输出目录必须不同;每批数据跑完需要重启程序(网页版刷新即可)。
- 标样漂移回归
regression()写了但没接线——上游没有界面控件能触发它。
关于这份文档About this page
把话说在前面
这个站点的文字、英文翻译、图表与全部工程改动的说明,由 AI 助手协助整理, 经仓库维护者审阅后发布。AI 会出错——发现错误请 开 issue, 这条比任何其它反馈都有用。
维护者是这套软件的使用者,不是 Isoclock 的作者,也不是这里引用的 任何一种方法的提出者。凡是涉及方法学的判断,一律以原始论文、官方手册和 上游代码为准;本页与图解教程只做解释。
页面上的每一个数字(334 项比对、690 个输出格、4.1×、876 px 等)都来自仓库里 真正跑过的记录,出处在 webgui/README.md 与 docs/README.md, 重建命令也在那里。没有凭印象写的数。
引用、许可、联系Citation, licence, contact
引用软件
方法、软件、实现都归属于 Guoqi Liu(East China University of Technology)。
引用请用上游仓库与随附的 CITATION.cff:
github.com/sndjgm/Isoclock
联系方式 sndjgm@foxmail.com
这个 fork 只是工程实现上的维护,不构成一个新的软件,不建议单独引用。
方法学参考文献
Chew, D.M., Petrus, J.A., Kamber, B.S. (2014). U–Pb LA–ICPMS dating using accessory mineral standards with variable common Pb. Chemical Geology 363, 185–199.
Stacey, J.S., Kramers, J.D. (1975). Approximation of terrestrial lead isotope evolution by a two-stage model. EPSL 26, 207–221.
Wendt, I., Carl, C. (1991). The statistical distribution of the mean squared weighted deviation. Chemical Geology 86, 275–285.
²⁰⁸Pb 校正路径遵循 Zack et al. (2011)。
许可
Apache License 2.0,与上游一致。可以自由使用、修改、再分发, 请保留版权与许可声明。